Ottaako Model One yhteyden tietokantoihimme?
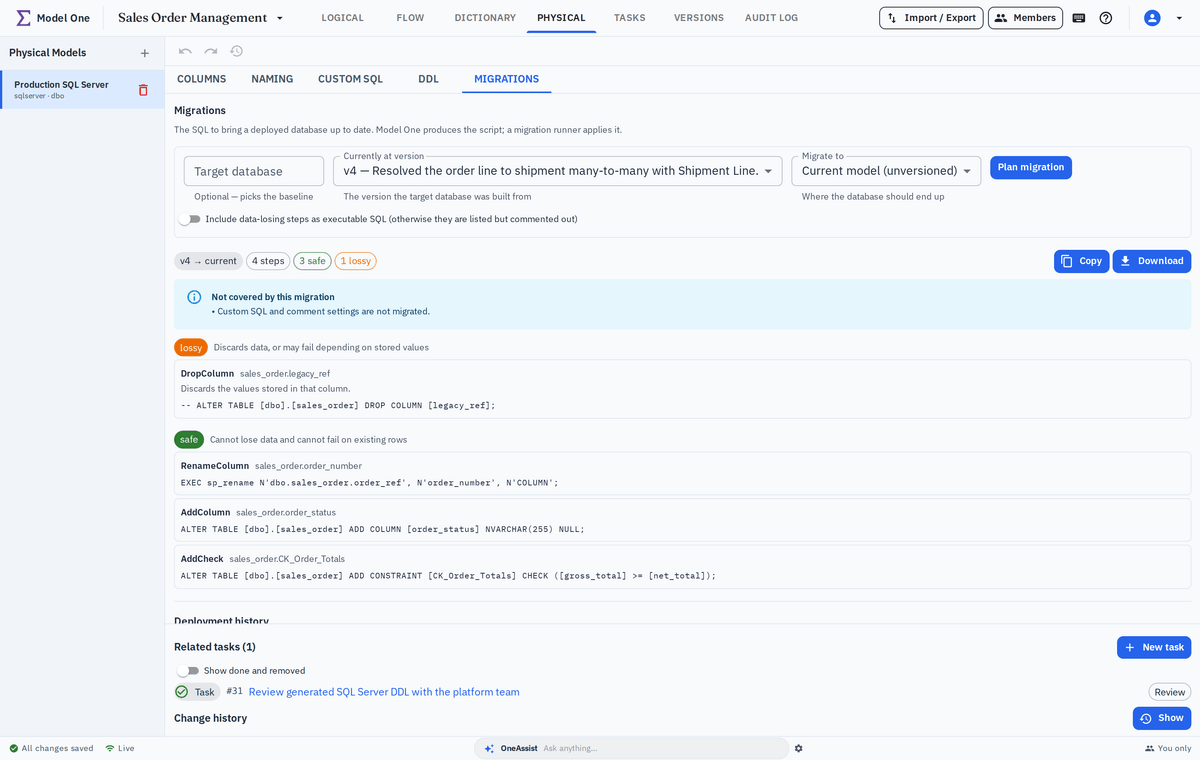
Ei. Se ei koskaan muodosta yhteyttä lähdejärjestelmään tai tietovarastoon eikä tallenna tietokantojen kirjautumistietoja. Se tuottaa DDL:n, migraatioskriptit ja dbt-projektin, ja tiimisi ajaa ne omilla työkaluillaan.
Onko käsitemalli erillinen malli?
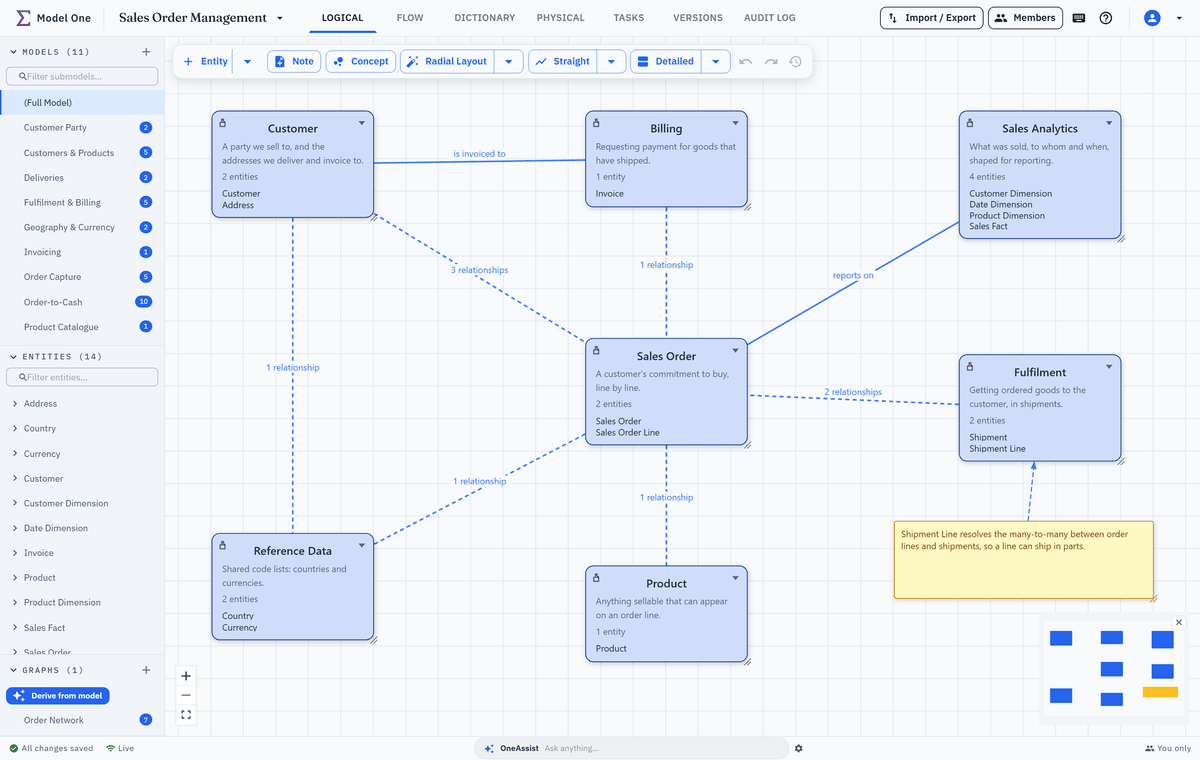
Ei, ja se on tarkoituksellista. Käsite on liiketoimintatason näkymä loogiseen malliin: se edustaa aihealuetta, se piirretään Full Model -näkymään, ja sen katkoviivat lasketaan alla olevista suhteista, joten ne eivät voi joutua ristiriitaan entiteettien kanssa. Käsitteellä on nimi, määritelmä ja nimettyjä yhteyksiä, mutta ei attribuutteja eikä kardinaliteettia. Jos käsitemallinne on tarkempi – liiketoiminnan käsitteet ja niiden väliset suhteet kardinaliteetteineen – piirtäkää käsitteet entiteetteinä aihealueen alimalliin ja näyttäkää alimalli Name + Definition -tilassa. Kaaviossa näkyvät silloin nimet, määritelmät ja suhteet ilman attribuutteja ja tietotyyppejä, ja samat entiteetit saavat attribuuttinsa ja avaimensa teknisessä suunnittelussa.
Entä raportointikerros ja Power BI?
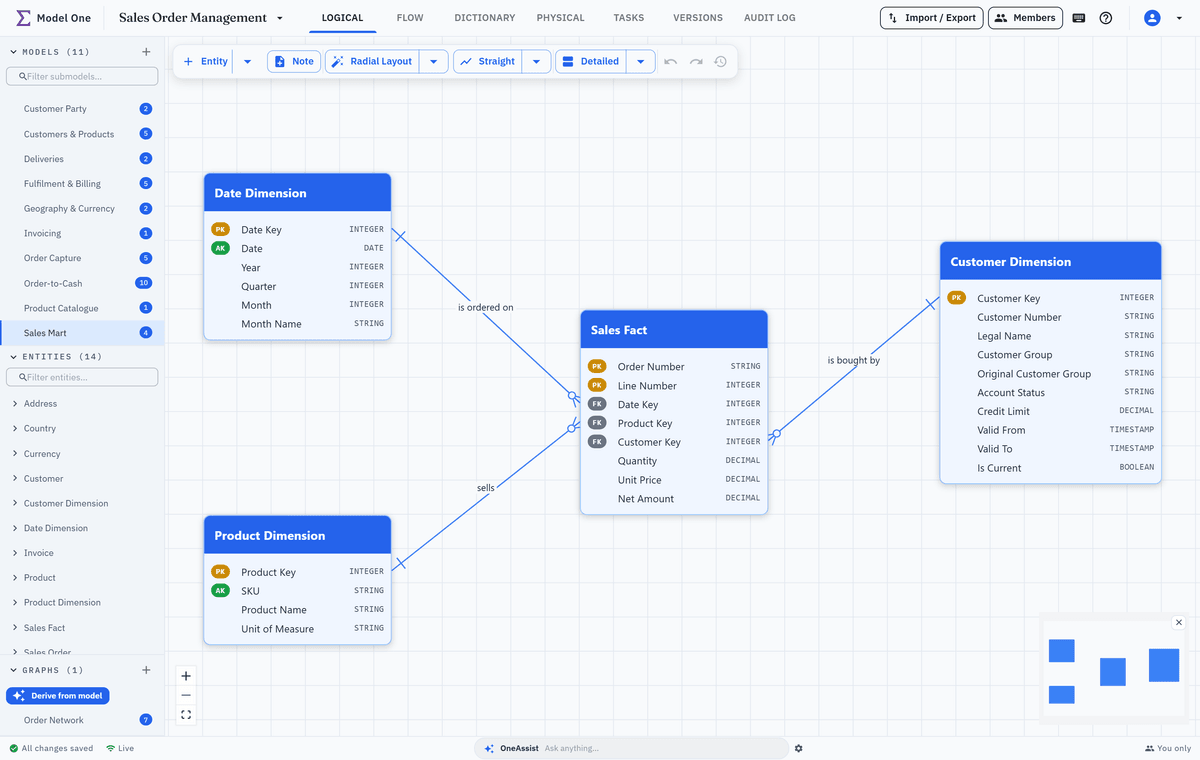
Model One suunnittelee ja generoi tietovaraston ja raporttiesi lukemat datamartit, mukaan lukien SCD2-dimensiot ja Aggregate-vaiheet. Se ei rakenna Power BI:n semanttisia malleja, mittareita eikä raportteja: ne tehdään BI-työkalussasi. Raportin tai BI-työkalun voi silti dokumentoida Flow-kaavioon ulkoisena järjestelmänä.
Meillä on jo tietovarasto, jota mallinnamme ER/Studiolla. Mistä aloitamme?
Tuo ER/Studion DM1-tiedostot, joista tulevat mukaan entiteetit, avaimet, alimallit, fyysiset nimet ja tyypit, tietolähteet ja Data Lineage -kaaviot, tai liitä tietovaraston DDL, josta syntyy looginen ja fyysinen malli natiivein tietotyypein. Tallenna tulos versioksi ja kirjaa käyttöönottohistoriaan, että tämä versio on tuotannossa. Silloin seuraavan muutoksen voi viedä migraationa.
Tukeeko se SCD2:ta ja Data Vaultia?
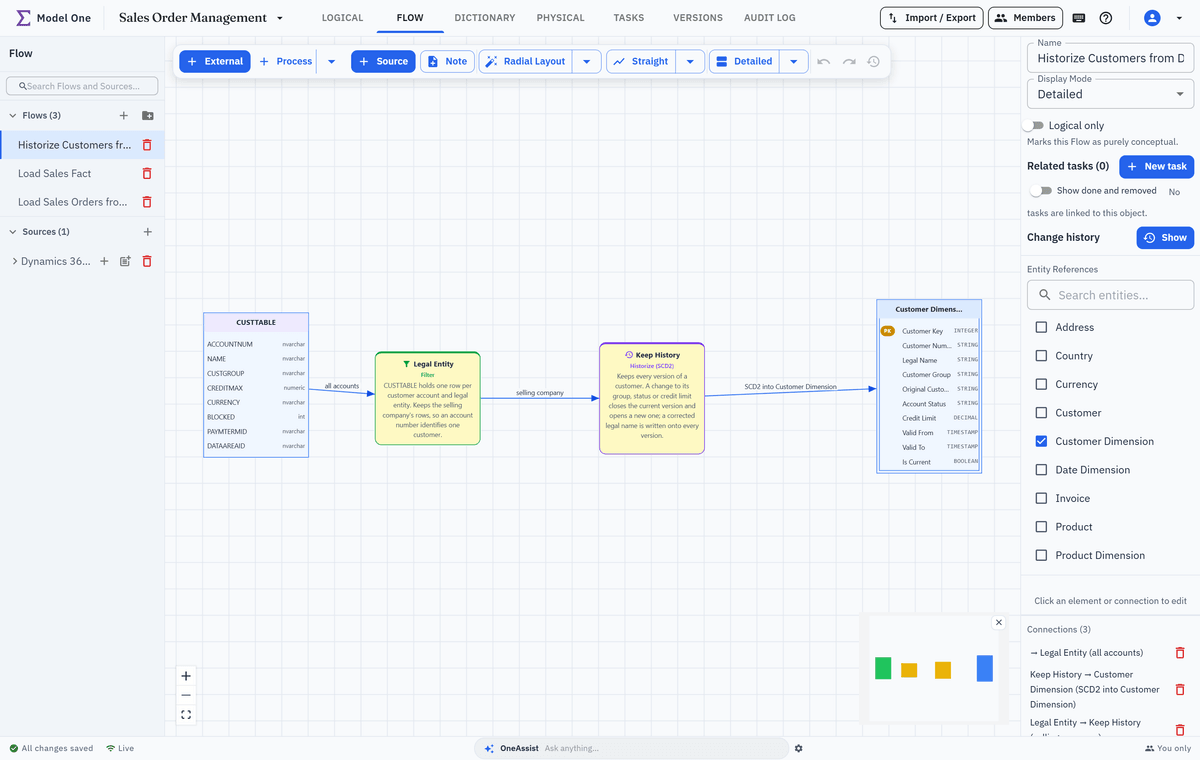
Rakennuspalikoin, ei generaattorilla. Historize lataa tyypin 2 dimensiot tai insert-only-satelliitit liiketoiminta-avaimen ja sarakekohtaisen historiointitavan perusteella, ja Hash muodostaa hubien ja linkkien avaimet sekä muutostiivisteet (hash diff). Hubit, linkit ja satelliitit mallinnat itse; nämä vaiheet lataavat ne.
Miten dbt-projekti sopii CI-putkeemme?
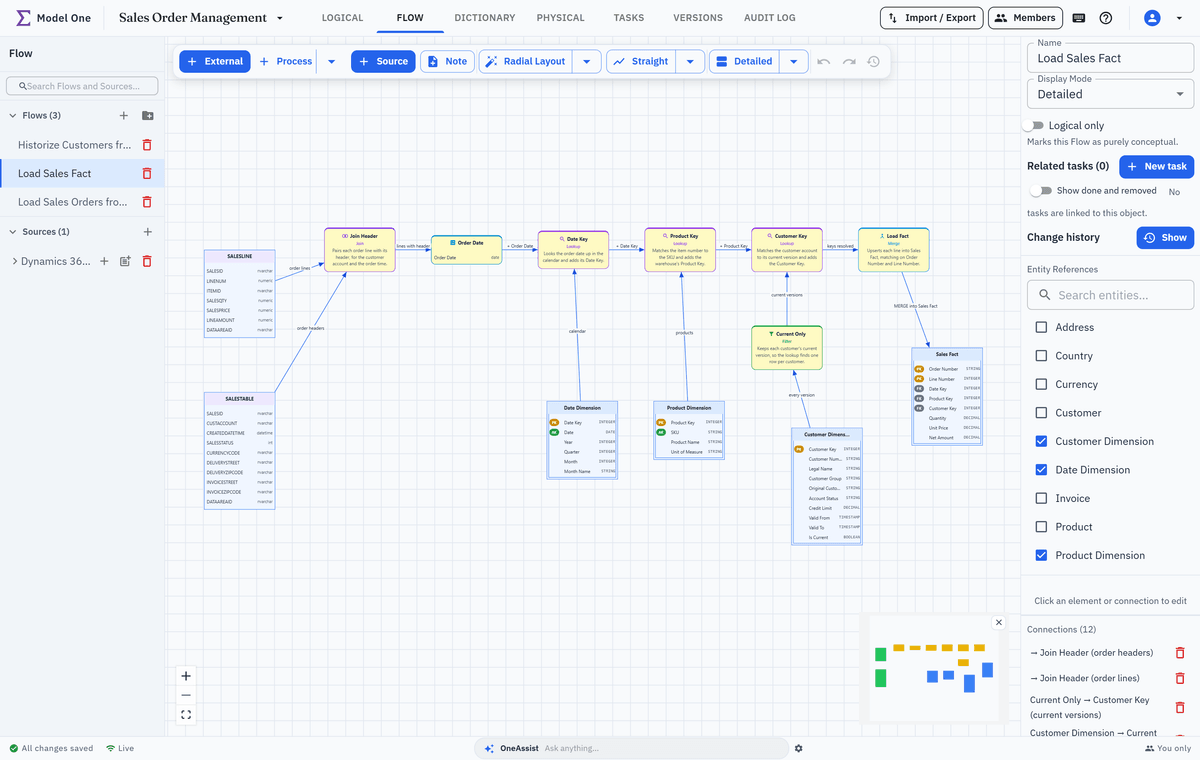
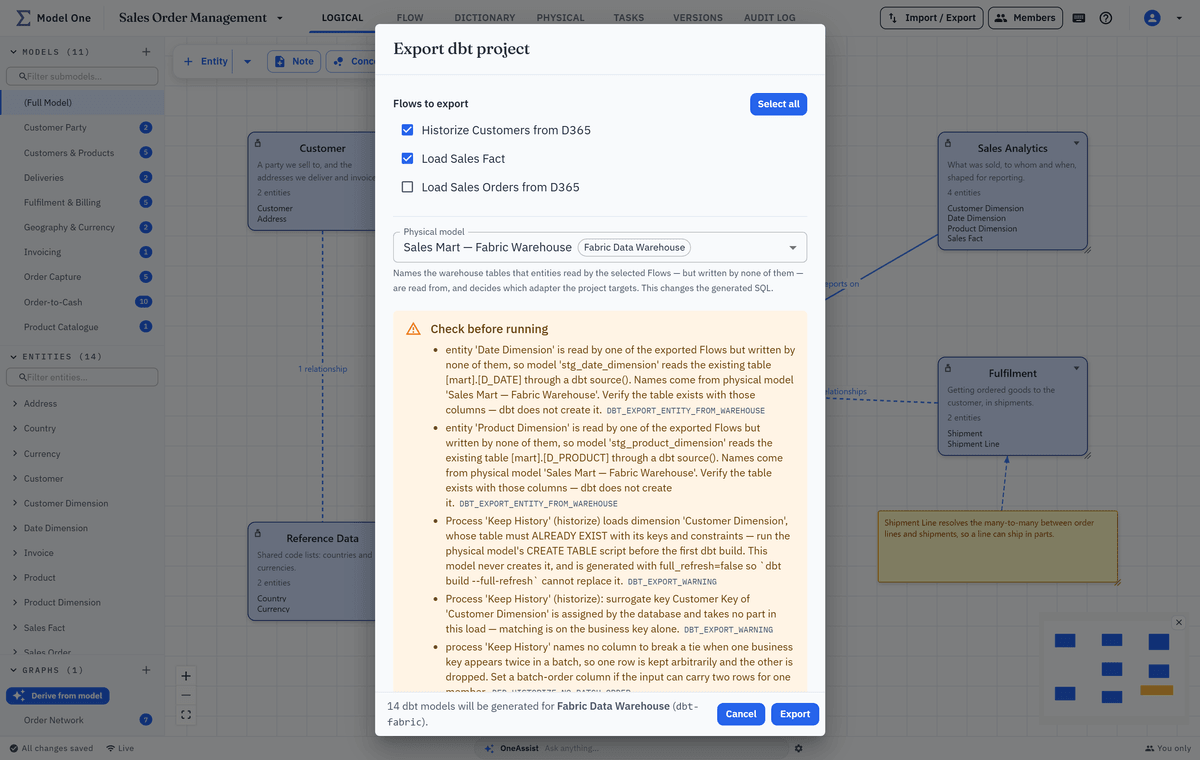
Se on tavallinen dbt-projekti dbt-fabricille tai dbt-sqlserverille. Saat sen .zip-tiedostona, ja mukana tuleva README luettelee tarkistettavat asiat. Vie se repositorioosi ja aja se CI:stä kuten mitä tahansa muuta dbt-projektia. Kun malli muuttuu, tee vienti uudelleen: se generoi aina koko projektin nykyisestä mallista, joten muutos näkyy repositoriossa tavallisena erona (diff), ja Merge-lataukset lisäävät uudet sarakkeet olemassa oleviin kohdetauluihinsa itse. Taulut, joiden avainarvot tietokanta muodostaa, ja jokainen Historize-kohde on luotava generoidulla DDL:llä ennen ensimmäistä dbt build -ajoa.
Voivatko liiketoiminnan omistajat osallistua ilman muokkausoikeuksia?
Kyllä. Anna heille katselijan (Viewer) rooli: he voivat lukea kaikkia moduuleja käsitekartta mukaan lukien ja viedä HTML-raportin, mutta eivät voi muuttaa mitään. HTML-raportti aukeaa missä tahansa nykyaikaisessa selaimessa, joten myös ne, joilla ei ole käyttäjätiliä, voivat lukea sitä. Raportissa ovat looginen malli, Flow-kaaviot, sanasto ja DDL, mutta ei käsitekarttaa, joka katselmoidaan sovelluksessa.
Missä tietomme sijaitsevat ja lähetetäänkö niitä minnekään?
Model One asennetaan omaan Azure-tilaukseesi valitsemallesi alueelle, ja se tallentaa sen, mitä mallinnat — ei koskaan tietokantojesi rivejä. OneAssist on valinnainen: kun se on otettu käyttöön, kehotteet ja mallin konteksti käsitellään Azure AI Foundryssa omassa tilauksessasi. Sen verkkohaku, joka hakee tietoa julkisesta verkosta, on oletuksena päällä, ja sen voi kytkeä pois vain agenttia luotaessa.